約15分で分かるMLモデル管理
同じ条件で評価し、
採用理由を残し、問題時に戻す。
機械学習は、モデルを一度学習して終わる仕事ではありません。 現在採用中のモデル(Champion)と更新候補(Candidate)を同じ条件で比較し、採用根拠を残して安全に切り替える。その開発・運用の仕組みを解説します。
約15分で読めます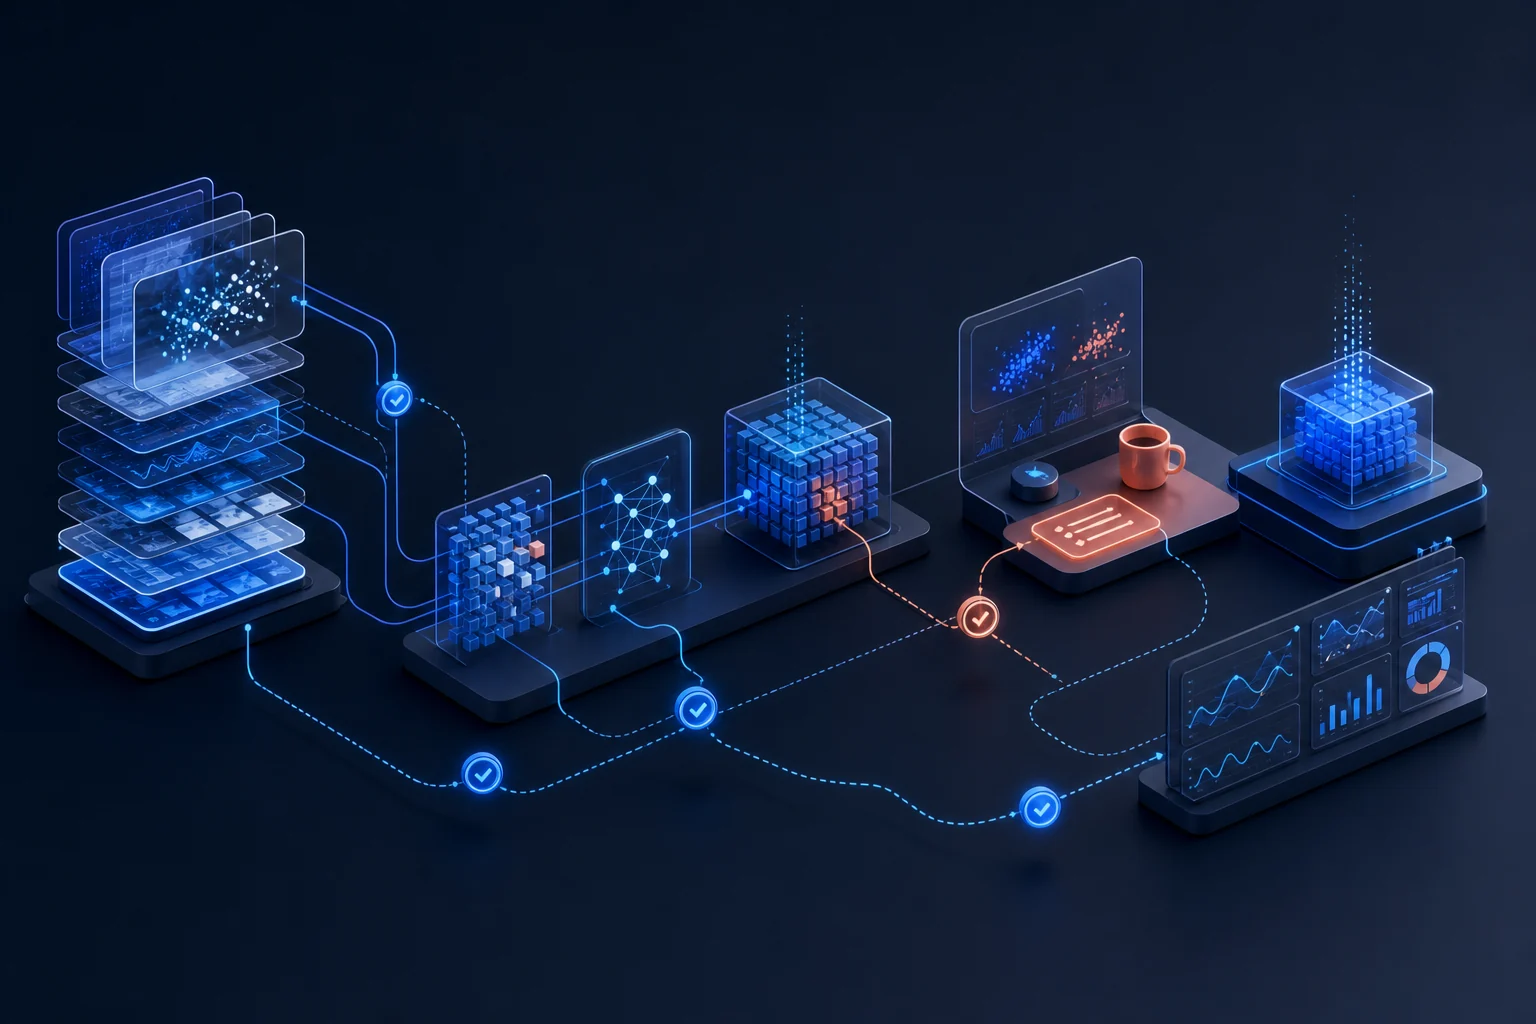
モデルの前後に必要な設計
モデル精度だけでなく、
改善プロセスを設計する。
モデルを更新すれば多数のパラメータが変わりますが、重みを直接比較しても業務上の改善は判断できません。 評価データ、指標、合格条件が揃って初めて、変更による効果と性能劣化(Regression)を測れます。
このポートフォリオは、データセットと分割条件の版管理、現行モデルと更新候補の比較、採用の合格条件、推論時に残す作成・評価の来歴を実装しました。 高性能な基盤モデルを開発したという主張ではなく、改善を再現可能かつレビュー可能に進めるMLエンジニアリングの実証です。
この記事は、モデルを再現するための手順書ではありません
公開リポジトリの設計、コード、評価結果ファイルを根拠にしていますが、学習commandを順に実行する手順書ではありません。 MLモデルの比較、採用、追跡、問題時の復旧をどう設計したかに焦点を当てています。
文書処理で実装した範囲
文書分類で、
ML基盤を実証した。
公開版の出力は文書クラスですが、モデルの周辺に構築した受付、非同期実行、レビュー、監査、評価、昇格の仕組みは、項目抽出や図面解析でも必要になります。
文書分類(Document Classification)
英語の請求書と報告書を対象に、分類、人による確認(Human-in-the-loop)、評価、モデル採用までを実装しています。
項目・表の構造化(Structured Extraction)
OCRと文書配置の解析を組み合わせ、項目、表、キーと値を座標付きの構造化データとして扱う拡張です。
設計図面の読み取り(Drawing Intelligence)
図面内の文字、記号、寸法、表題欄、改訂差分を検出し、根拠位置とともにレビューへ渡す構想です。
審査付きのモデル管理
処理対象が変わっても、データセット審査、評価の合格条件、モデルの来歴、人の訂正を扱う境界は共通化できます。
管理の仕組みは再利用できても、モデルと入出力形式は作業ごとに設計します
図面解析では、画像解像度や座標系、検出位置を囲む枠、記号の分類体系、CAD/BIMデータとの対応、正解ラベル付けと確認の専用画面が必要です。分類APIのlabelを増やすだけで実現できる機能ではなく、対象業務のデータと合格条件を使った別の実証が必要です。
仕組みで防ぐ評価・運用上の問題
ML開発で起こりやすい、
評価と運用の問題。
データ、前処理、モデル、評価条件が同時に変化するため、意図せず比較可能性や追跡可能性を失うことがあります。個人の注意力ではなく、仕組みで防ぐ対象です。
全体指標だけでは、クラス別の悪化を見落とす
全体の正解率(Accuracy)が上がっても、特定クラスの再現率(Recall)が下がることはあります。採用条件が曖昧なままでは、モデル更新のたびに判断が変わります。
評価データや分割条件が変わると、公平に比較できない
前回と今回で評価データや分割条件が違えば、差分がモデルによるものか試験条件によるものか切り分けられません。
新しいモデルが、現在採用中のモデルより良いとは限らない
学習が完了してモデルファイルが生成されたことと、利用先を新しい版へ切り替えられることは別です。一部の指標だけ悪化する場合もあります。
モデルだけ残しても、同じリリースへ戻れない
モデルファイルがあっても、データ、前処理、評価方針、ラベル定義が不明なら、当時の実行条件を再現できません。
人の訂正を、無審査で学習データにはできない
訂正は貴重ですが、利用許諾、入力ミス、個人情報、重複、ラベル品質を確認せず学習へ混ぜるとデータ汚染につながります。
作成条件から推論結果までを一つにつなぐ
データセットから推論結果まで、
作成・評価の来歴を切らさない。
学習処理だけを独立させず、入力データ、生成したモデル、評価結果、採用判断、実行時の推論結果を六つの段階で関連付けています。
- 01固定する
データセットと分割条件を固定
18件の合成文書を学習用(train)12件、調整確認用(validation)2件、最終評価用(holdout test)4件へ固定し、同系統のテンプレートが複数区分へ混ざらないことも検査します。
- 02作成する
同じ更新候補を再作成できる
データ、前処理、依存関係、乱数の初期値(seed)を固定し、同じ内容の更新候補モデル(Candidate)を再生成できることを確認します。
- 03評価する
文書ごとの評価結果を保存
最終評価用データの各文書について、正解、予測、モデルスコアを保存し、集計指標を元の結果から再計算します。
- 04比較する
現行モデルと更新候補を比較
同じ評価データで、必ず満たす条件を通るか、現行モデル(Champion)から許容幅を超えて悪化していないかを判定します。
- 05採用する
承認済みの採用目録を保存
合格したモデルを、データセット、前処理、評価条件、評価レポートと一つの採用目録(promotion manifest)で結びます。
- 06追跡する
推論時の来歴を保存
推論結果へ採用版の識別子と作成・評価の来歴(lineage)を保存し、どのモデル構成が出力したかを後から追跡できます。
モデルを比べる評価指標
集約指標とクラス別指標を、
同じレポートで評価する。
たとえば請求書の見落としが増え、報告書の正解だけが増えた場合、全体の正解率(Accuracy)だけでは性能劣化を見落とす可能性があります。 この実装では、請求書と報告書の適合率(Precision)、再現率(Recall)、F1を分類先ごとに算出し、各分類を同じ重みで集計するMacro F1と併せて評価します。
モデル内部のパラメータ差分ではなく、固定した最終評価用データ(holdout)に対する出力差分を採用判断に使います。
請求書だと予測した中の
誤検出を測る。
請求書と予測した文書のうち、実際に請求書だった割合です。誤検出を抑えたい場合に重視します。
対象の分類先の
見落としを測る。
実際の請求書のうち、請求書として検出できた割合です。見落としを抑えたい場合に重視します。
適合率と再現率を
一つの指標で比較する。
適合率と再現率の調和平均です。どちらか一方だけが高いモデルを評価しすぎないために使います。
各クラスを同じ重みで
集約する。
分類先ごとのF1を単純平均し、文書数の多い分類先だけで全体指標が決まることを避けます。
実証用データでの限定評価
公開版の限定評価
最終評価(holdout test)は公開用の合成文書4件です。更新候補は4件すべてを処理し、請求書・報告書ともに各指標1.0でした。 これは評価処理と採用判定が最後まで動いた証拠であり、実データに対する精度100%を意味しません。
モデルスコアを、校正済み確率として扱わない
0.99という出力を「99%の確率で正しい」と解釈するには、確率校正(calibration)の検証が必要です。この実装は校正を行っていないため、値をモデルスコアと呼び、確率や信頼度の証明には使いません。
現行モデルと更新候補の比較
更新候補は、
評価の合格条件を通してから採用する。
現在採用中のモデル(Champion)と更新候補(Candidate)を同じ評価条件で比較します。新しいモデルが生成されただけでは、利用先を切り替えません。
絶対基準を事前定義する
Macro F1、分類先ごとの再現率(Recall)、全件処理、失敗件数に最低条件を設定します。
現行モデルと比べた性能劣化を測る
全体・分類先別の指標とモデルスコアが、許容した悪化幅を超えないか判定します。
サンプル単位の結果から再計算する
保存済みの集計値をそのまま信用せず、各サンプルの予測から指標と合否を再計算します。
今回の更新候補は現行モデルを大幅に上回ったのではなく、絶対基準を満たし、この限定的な最終評価用データで性能劣化がないと確認されたものです。 「性能が改善した」と「採用条件を満たした」を区別して記録しています。
採用時に残す復旧単位
ロールバック単位は、
モデルだけではない。
ここで扱うロールバック対象は、学習途中のパラメータを保存する学習checkpointとは異なります。 保存するのは、審査を通ったMLリリース一式です。
直前の現行モデルも同じ合格条件を通過した参照先として残します。問題が起きた場合はモデルを上書きせず、採用根拠を結んだ目録(manifest)を前のリリースへ切り替えます。
実行時の推論結果に残す証拠
推論結果に、
使用したモデルの来歴を残す。
採用時の目録だけでは、実際の推論がどのモデルで実行されたかを追跡できません。処理結果に版、モデル内容を識別するhash、データセットなどの来歴(lineage)を保存します。
採用記録と一致しなければ起動を止める
モデルのhashや評価根拠が採用目録と一致しない場合、別の「最新」ファイルへ切り替えず、安全側へ停止します(fail closed)。
推論と人の最終判断を分離する
人が承認・訂正しても、その時点の推論結果とモデルの来歴は変更しない監査記録として残します。
推論から昇格根拠を逆引きする
記録された識別子からデータセット、パイプライン、モデル、評価ポリシー、評価レポートまで追跡できます。
人の訂正を学習へ使う境界
人の訂正を、
無審査で再学習へ流さない。
利用者による訂正は将来の改善候補になります。ただし、業務上の最終判断と、学習データとして利用可能であることは別の条件です。
訂正はまず学習候補として分離します。出所(provenance)、利用許諾、個人を特定できる情報(PII)、正解labelの品質、重複、評価用データの混入(data leakage)を人が確認し、審査を通ったものだけを将来のデータセットへ採用します。
自動再学習・無審査のモデル昇格は行わない
記録を作るだけでなく不整合を拒否する
マニフェストを作るだけでなく、
不整合をテストで拒否する。
自動testでは、正しい更新候補が通る正常系に加え、作成・評価の来歴を改変したモデルや未審査の最新版を拒否する異常系も確認します。
更新候補を再buildする
同じ入力から生成した二つのモデルで、内容とSHA-256が一致することを確認します。
評価を再実行する
全testを二度実行し、文書ごとの結果から再計算したレポートが1 byte単位で一致することを確認します。
破損した来歴を拒否する
データセットやレポートの参照を改変した場合、昇格判定と実行環境の起動時検証が失敗することを確認します。
現時点で実証していない範囲
公開版で実証していない範囲。
- 対象は英語の請求書と報告書だけで、公開用に作成した小規模な合成データセットです。
- 最終評価(holdout test)は4件です。各指標1.0でも、実業務データの精度や未知データへの対応力は証明しません。
- OCR、手書き、複数ページ、表、未知の文書配置、図面、時間経過によるデータ傾向の変化(data drift)は評価していません。
- モデルスコアは校正済み確率ではなく、公平性、頑健性、プライバシーも評価対象外です。
- 利用者向けの正解label付け、学習、モデル採用画面や、自動再学習を備えたMLOps製品ではありません。
- 実業務への導入には、対象データを使った評価、セキュリティ、監視、可用性、運用体制の追加設計が必要です。
参照資料と検証方法
記載内容を、
公開実装と一次資料で照合。
2026年8月14日時点のPortfolio mainにあるModel Card、ADR、機械が読める評価結果ファイル、検証コードを照合しています。拡張構想は現在の実装と区別して記載しました。
次に確認できる内容
システム全体、AWS実地検証、
公開リポジトリへ。
約10分の概説では文書処理(Document Intelligence)基盤の全体像、AWS編では環境構築から撤収、GitHubでは実装と評価結果ファイルを確認できます。