Google検索へ伝えた実装と観測記録
Google検索の、
取得・索引・
表示を観測する。
Search Console、サイトマップ、構造化データ、代表画像、favicon。 ReactorFront(リアクターフロント)がGoogleへ判断材料を渡すために整えた実装と、Googleが決めた表示を条件付きで観測した記録です。
約15分 / 実地確認: 2026-08-18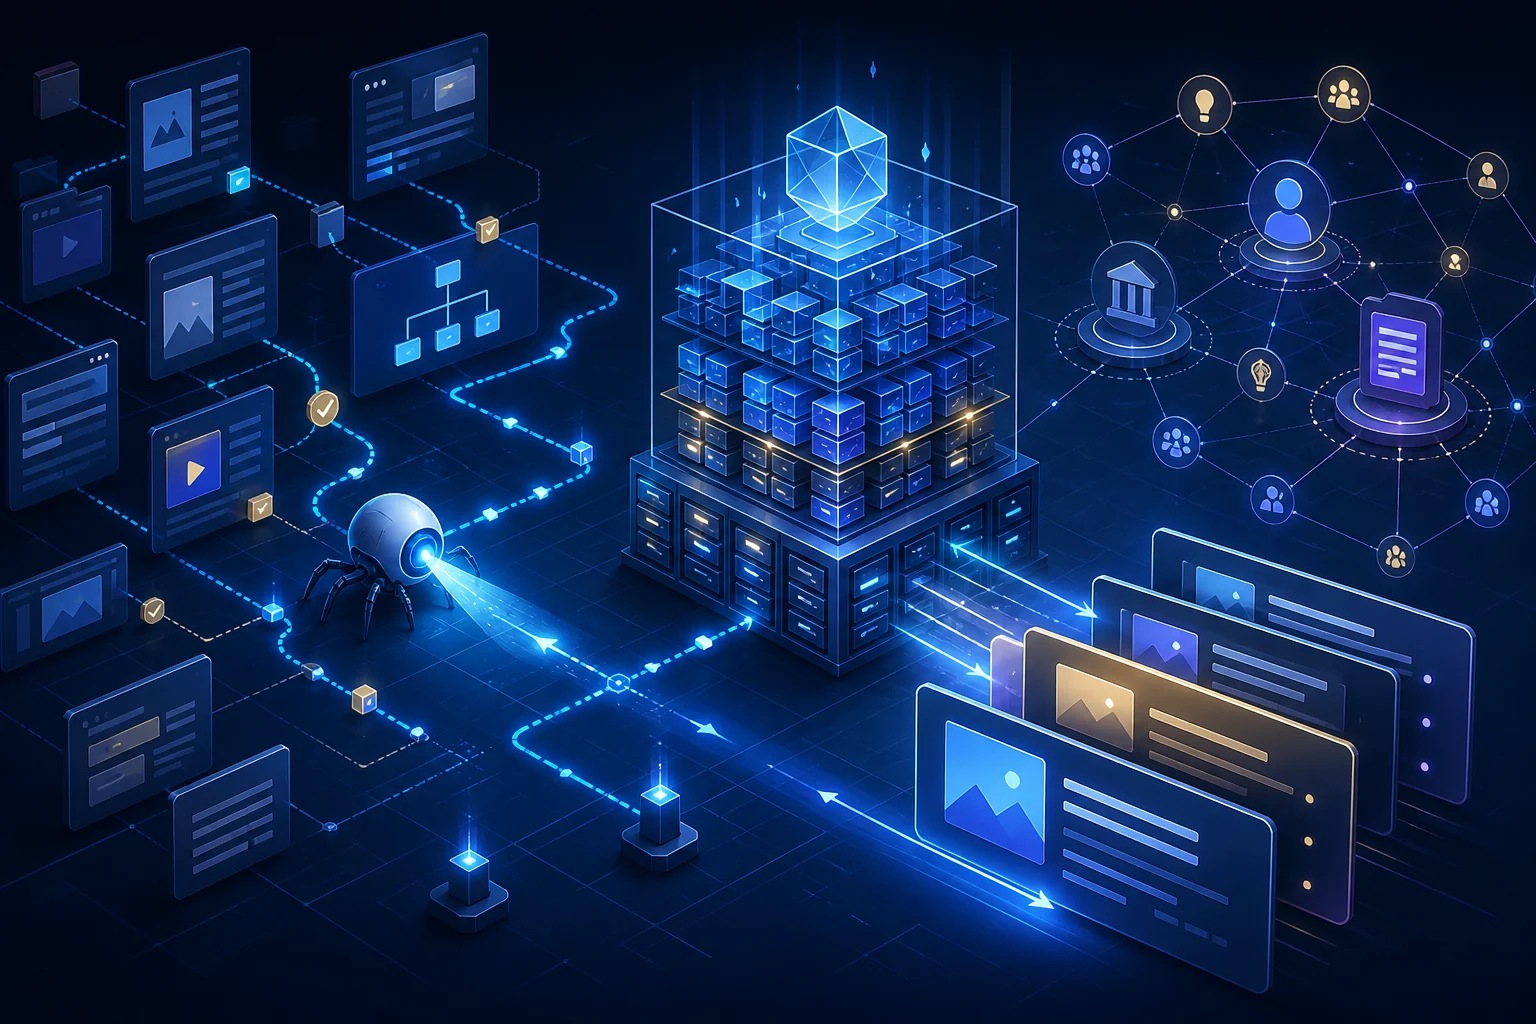
公開後に始めたこと
公開できた。
しかし、Googleが見ている姿は
まだ古かった。
ReactorFrontのサイト自体は、全面刷新より前からGoogleに登録されていました。 今回困っていたのは「検索に一度も出ない」ことではありません。内容もデザインも作り直したのに、検索結果には以前の説明や、屋号と無関係な文脈が残っていたことでした。
必要だったのは新規登録ではなく、更新したページをもう一度取得してもらうことです。 そこでSearch Consoleを導入し、検索エンジンがページを見つけ、読み、関係を理解するまでの入口を一つずつ確認しました。
この記事は、検索順位を保証する方法や、キーワードを詰め込む手順ではありません。 自分のサイトを正しく公開し、外から検証し、Googleへ判断材料を渡したケーススタディです。
Google検索の三段階
クロール、インデックス、表示。
まず三つを分けて考える。
「Googleに載る」という一言の中には、別々の処理があります。ここを混ぜると、サイトマップを送れば順位が上がる、再リクエストすれば表示が即時更新される、といった誤解につながります。
見つけて、取得する
GooglebotがURLを発見し、HTMLや画像を取りに来る段階です。robots.txtやHTTP応答が、まずここへ影響します。
内容と関係を理解する
取得した本文、画像、タイトル、canonical、構造化データなどを解析し、検索用の索引へ保存する段階です。
検索語に応じて表示する
検索語、場所、言語、端末などに応じて、どのページや表示要素を出すかGoogleが判断する段階です。
Search Consoleへ申請する前の確認
申請より先に、
読みに来られるサイトへ整える。
Search Consoleは、壊れた公開状態を直してくれるサービスではありません。 最初に、Googlebotと一般利用者が同じ正規URLへ到達し、HTMLと画像を取得できることを確認しました。
クロールを妨げていない
全クローラーを許可し、XMLサイトマップの正規URLを案内しています。
公開ページを一覧で渡す
主要ページの絶対URLをXMLで列挙し、新しい記事も公開時に追加します。
代表URLを一つに寄せる
各ページにwww付きHTTPSのcanonicalを置き、ルートドメインから同じ正規URLへ転送します。
外から読める状態を確認する
HTTPS 200、noindexなし、本文と主要画像がHTMLから取得できることを本番環境で確認します。
ドメイン全体を登録
wwwだけでなく、ドメイン全体を観測する。
Search ConsoleにはURLプレフィックスとドメインプロパティがあります。
ReactorFrontでは、wwwの有無やHTTP / HTTPSをまとめて扱えるドメインプロパティ reactorfront.jp を選びました。
DNSで所有者だと確認
DNSのTXTで、ドメイン所有者だと証明する。
ドメインプロパティの所有権確認には、Googleが発行したTXTレコードを権威DNSへ追加します。 XServerドメインの既存レコードは変更せず、確認用TXTを一件だけ追加しました。公開DNSへ反映された後、Search Console側で確認しています。
Host: @
Type: TXT
Value: <Search Consoleが発行した確認値>Search Consoleは確認状態を継続して確かめます。記事やスクリーンショットには実トークンを載せず、DNS上の確認レコードは維持します。
公開URL一覧を送信
公開しているURLを、一覧で知らせる。
sitemap.xml へ主要ページの正規URLを収録し、Search Consoleから送信しました。
サイトマップはページの存在を知らせる手段であり、登録や順位を保証するものではありません。新しい記事を公開する時は、同じ一覧へ追加します。
登録状態と現在の公開状態を確認
過去の登録状態と、現在の公開状態を分けて見る。
URL検査では、Googleが最後に把握したインデックス情報を確認できます。 さらに公開URLテストを実行し、現在の本番ページを取得可能か確かめてから、再インデックス登録を依頼しました。
- ページがインデックス登録済みか
- 正規URLが意図したURLか
- HTTPSで配信されているか
- 現在の公開URLをGoogleが取得できるか
再取得を依頼して待つ
大きな更新後だけ依頼し、あとは待つ。
Search Consoleで「優先クロールキューへ追加」と表示されても、処理時期はGoogleが決めます。 同じURLを何度も送っても順番や優先度は上がらないため、公開検証、申請、観測を一回の変更単位として扱いました。
名前の羅列ではなく、公開情報の関係を示す
文字列を増やすのではなく、
誰の、何というサイトかを結ぶ。
屋号、代表者、サイト、各ページを別々の文字列として置くだけでなく、構造化データの識別子で関係を示しました。画面に書いていない実績を足すのではなく、公開内容を機械にも読める形へそろえます。
ReactorFront、リアクターフロント、小文字の reactorfront は同じ事業者・サイトの表記として同じnodeへ置き、www.reactorfront.jp はサイトのhost名として区別します。
公開用に一般化したJSON-LD例
三つの表記を、同じWebSiteへ置く。
name は優先するサイト名、alternateName は別表記です。
別表記は「リアクターフロント」「reactorfront」の順に置きます。発行者は文字列で重ねず、事業者の @id を参照します。
これは候補と関係を伝える実装であり、Googleが検索結果のサイト名へ採用する保証ではありません。
{
  "@type": "WebSite",
  "@id": "https://www.example.com/#website",
  "name": "ReactorFront",
  "alternateName": [
    "リアクターフロント",
    "reactorfront"
  ],
  "publisher": {
    "@id": "https://www.example.com/#organization"
  }
}代表画像・共有画像・favicon
文章以外の「顔」も、
取得できる形で公開する。
検索結果では、説明文だけでなく代表画像や、browser tabと検索結果に使う小さなsite icon(favicon)が使われる場合があります。 どの画像を表示するかはGoogleの自動判断ですが、候補を取得できなければ判断材料にもなりません。
CSS背景から、意味のある画像要素へ
夜景のヒーロー画像を picture / img でHTMLへ出し、代替テキスト、実寸、読み込み優先度を設定しました。
共有時の画像情報(OGP)と代表画像をそろえる
SNS等へ共有する時の画像情報(OGP)、Xカード、WebPageの primaryImageOfPage へ同じ画像を設定し、max-image-preview:large を許可しました。
正式ロゴとfaviconを同じ意匠へ統一
丸型RFアイコンを正式ロゴとして採用し、ヘッダー、フッター、構造化データ、faviconで同じブランド表現を使います。
サイト全体で同じ意匠を使う
正式ロゴからfaviconまで、一つの顔に。
Google検索のfaviconはホスト名単位です。AWS記事だけに別アイコンを付けるのではなく、www.reactorfront.jp全体を表すアイコンとして設定します。 正方形で48pxより大きい画像、クロール可能な安定URL、HTMLの画像要素を使い、サイト内外で同じ意匠を示します。実際の採用と反映時期はGoogleの判断です。
<link rel="icon" href="/brand/reactorfront-mark-192.png" sizes="192x192" /> 実際に観測したこと
表示の変化は記録する。
原因は決めつけない。
以下は2026-08-18に、検索語、Googleへのログイン状態、プライベートウィンドウを分けて観測した事実です。実装後、説明、画像、関連linkは少しずつ変わりましたが、同じ時期に複数の改善とGoogle側の再処理が進んでいます。個別施策だけの効果とは断定しません。
カタカナ表記は、別分野の語と競合した。
「リアクター」「フロント」という一般語の組み合わせから、楽器やバイク部品の文脈が検索結果へ混ざりました。後には事業内容が主回答になりましたが、別語義の残り方も検索環境で異なりました。
固有の英語表記は、競合が少なかった。
reactorfront では、ある観測時点の検索結果件数が12件と表示され、公式サイト、サイトリンク、LinkedInが上位へまとまりました。件数はGoogleの概算であり、厳密な索引数とは扱いません。
ログイン状態で、見え方は同じではなかった。
検索意図と異なる結果へフィードバックした後、ログイン中の画面は早く変化しました。一方、プライベートウィンドウには別分野が残りました。全利用者へ即時反映された証拠とは考えません。
要約が整っても、正本にはしない。
AIによる概要が事業領域を適切に説明する場面が増えた一方、公開リポジトリの未説明部分を誤って推測することもありました。正確な説明の正本は公式サイトとGitHubです。
公開済みの変更証拠
何を改善したかは、公開PRで追える。
- #20サイトマップを現行ページへ合わせる
ML記事を含む主要ページをXMLサイトマップへ収録し、Search Consoleから送信しました。
- #21代表画像を、取得できるHTMLへ出す
ヒーロー画像を実際のimg要素にし、OGP、primaryImageOfPage、画像プレビュー許可を整えました。
- #22屋号と代表者を明示する
ReactorFront、リアクターフロント、小野賢太郎、Kentaro Onoを本文と構造化データで一貫させました。
- #23WebSiteという実体を追加する
WebSite、ProfessionalService、Person、WebPageを@idで結び、英語名とカタカナ名の関係を示しました。
- #24検索結果用faviconを分離する
正式ロゴは維持し、検索結果やブラウザ向けに丸形RFアイコンを安定したURLで公開しました。
実装できる範囲とGoogleの判断
整えられるものと、
Googleが決めるものを分ける。
技術的な入口と情報の一貫性は管理できます。構造化データを公式要件へ合わせればリッチリザルトの表示資格は整えられますが、実際の表示は保証できません。クロール時期、順位、AI概要、画像、検索結果に追加表示されるサイト内link(サイトリンク)、faviconの最終表示はGoogleが判断します。
こちらで整える
- HTTPSで安定して応答するページ
- robots.txt、サイトマップ、canonical
- 本文と一致するタイトル・説明・構造化データ
- Rich Results Testで重大errorがない表示資格
- 取得可能な画像とfavicon
- 本番確認、変更履歴、定期的な観測
こちらでは決められない
- いつ再クロールするか
- ページを索引へ保存するか
- 検索語ごとの順位と表示形式
- リッチリザルトを実際に表示するか
- AI概要が生成されるか、その内容
- 代表画像、サイトリンク、faviconの採用
重要な内容更新の後に行うこと
公開後の確認を、
運用へ組み込む。
本番のHTTP応答を確認
新ページ、画像、favicon、サイトマップをCDN越しに取得し、生成した公開用fileと一致するか確認します。
正規URLと公開情報を確認
canonical、robots、OGP、構造化データ、link先を生成後のHTMLと本番HTMLで確認します。
重要な変更だけ再取得を依頼
公開URLテストが通ることを確認し、ホームや新しい主要記事を優先クロールキューへ送ります。
複数の条件で表示を見る
ログイン状態だけで判断せず、検索語、端末、プライベート検索の違いを観測記録として残します。
確認に使ったGoogle公式資料
画面や仕様は変わる。
最終確認は公式資料で行う。
以下は本記事の実装・記述を確認した一次資料です。確認日: 2026-08-18
公開基盤から検索での発見へ
公開して終わりではなく、
外から見える状態まで確認する。
ドメイン、DNS、Webサイト、メールを整えた後、そのサイトが検索エンジンからどう取得され、どう理解されるかも運用の一部でした。 小さな静的サイトでも、公開後には観測と改善が続きます。